Спекулятивное декодирование: маленькая модель угадывает, большая проверяет
Разбираю ретроспективу Google Research о спекулятивном декодировании: технике, которую они придумали в 2022 году и которая теперь используется почти везде.
Два наблюдения
1. Токены бывают разной сложности. После «Санкт-» следующий токен угадает кто угодно. А вот вывод в конце сложного рассуждения требует большой модели. Значит, на простых местах маленькая модель справилась бы не хуже.
2. Генерация упирается в память, а не в вычисления. Чтобы выдать один токен, большая модель читает из памяти все свои веса. Вычислительные блоки GPU при этом в основном простаивают. Проверить сразу несколько токенов почти так же дорого, как сгенерировать один: веса всё равно читаются один раз.
Идея
Вдохновение пришло из процессоров, из предсказания ветвлений: процессор не ждёт результата условия, а начинает выполнять наиболее вероятную ветку и откатывается, если ошибся.
Здесь так же:
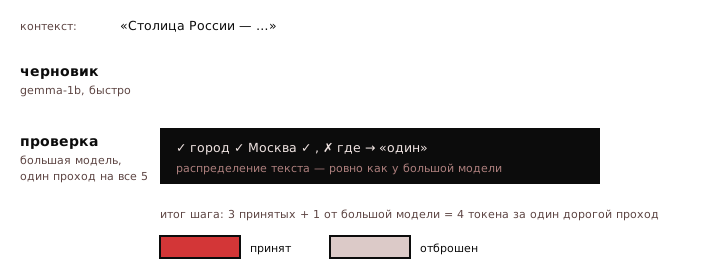
- Маленькая черновая модель быстро генерирует несколько токенов вперёд.
- Большая целевая модель проверяет их все за один проход, параллельно.
- Токены принимаются, пока они совпадают с тем, что выбрала бы большая модель. На первом несовпадении большая модель ставит свой токен, и цикл повторяется.
Главное: качество не страдает
Специальная схема принятия, speculative sampling, гарантирует, что распределение итогового текста точно такое же, как если бы всё генерировала большая модель. Это не приближение и не дистилляция, а то же самое, только быстрее. На практике ускорение в 2–3 раза.
Где используется
В Google техника работает, например, в AI Overviews в поиске: качество ответов прежнее, стоимость ниже. Идею развили и снаружи: распределённые варианты, генерация изображений, синтез речи.
Мой комментарий
У меня в Еве уже есть естественная пара для этого: маленькая Gemma-1B и большие модели. Но есть условие: у черновой и целевой модели должен совпадать токенизатор, иначе сравнивать нечего. У Gemma и Aya словари разные, поэтому в лоб не выйдет. Нужна черновая модель из того же семейства, что и целевая.
И вторая мысль: спекулятивное декодирование меняет компромисс по памяти. Вторая модель занимает VRAM, но экономит время. На моих 8 ГБ это решение, которое должен принимать планировщик в зависимости от того, что сейчас загружено.