Mixture of Experts: почему у модели 47 миллиардов параметров, а работают 13
Mixtral, DeepSeek, Jamba, половина современных больших моделей — это Mixture of Experts (MoE). В реестре Евы MoE-модели тоже есть, и с ними связан главный подвох для 8 ГБ. Разбираю обзор Hugging Face.
Как устроено
В обычном трансформере после внимания каждый токен проходит через один большой feed-forward слой. В MoE этот слой заменяется на:
- несколько экспертов: несколько отдельных feed-forward сетей;
- роутер (gate): маленькую сеть, которая для каждого токена решает, к каким экспертам его отправить. Обычно к одному или двум лучшим.
Каждый токен проходит только через часть экспертов. Остальные для него не считаются.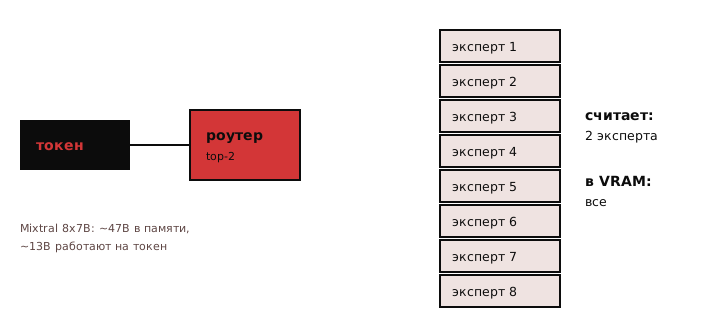
Почему это выгодно
- Обучение дешевле: при том же бюджете вычислений можно обучить модель с гораздо большим числом параметров.
- Инференс быстрее, чем у плотной модели того же размера: вычисления идут только через активных экспертов.
Пример — Mixtral 8x7B: в сумме около 47 миллиардов параметров (не 56: внимание у экспертов общее), а на каждый токен работает примерно 12–13 миллиардов.
Подводные камни
Память. Вот главный для меня момент: в VRAM нужно держать всех экспертов. Модель считает как 13B, а места занимает как 47B. Разреженность экономит вычисления, но не память.
Балансировка. Если роутер полюбит пару экспертов, они будут перегружены, а остальные не обучатся. Поэтому при обучении добавляют вспомогательную функцию потерь, которая штрафует неравномерное распределение токенов.
Дообучение. Разреженные модели легче переобучаются на маленьких датасетах, хотя instruction tuning для них в последнее время работает лучше.
История
Идея не новая: первая работа об адаптивных смесях экспертов вышла в 1991 году. В трансформеры MoE принесли Шазир и соавторы в 2017-м, дальше были GShard, Switch Transformer и Mixtral.
Мой комментарий
Для локального запуска MoE — это обмен памяти на скорость, а у меня как раз памяти меньше всего. Вывод для планировщика Евы: «активные параметры» годятся для оценки времени, а для оценки памяти нужно «всего параметров». Если перепутать, модель «влезет» по расчёту и не влезет на деле. Поэтому в реестре моделей у каждой записи свой явный бюджет vram_mb, а не вычисленный по размеру одного эксперта.
Есть и выход: держать экспертов в оперативной памяти, а на GPU — только общие слои и горячих экспертов. Llama.cpp такое умеет, но скорость падает. Это тот самый гибридный режим CPU+GPU, который я сейчас как раз меряю в бенчмарках Евы.