KV-cache: почему генерация не пересчитывает весь текст заново
Вчера я разобрал, как ужать веса модели. Но даже ужатая модель может упереться в память на длинном диалоге. Виноват KV-кеш. Разбираю статью из блога Hugging Face.
Как генерирует трансформер
Языковая модель пишет текст по одному токену. Чтобы выбрать следующий токен, механизм внимания сравнивает текущий токен со всеми предыдущими. Для каждого токена считаются три вектора:
- Q (query): что я ищу;
- K (key): что я из себя представляю;
- V (value): что я передам, если меня выберут.
Наивная генерация на каждом шаге заново прогоняет всю последовательность и пересчитывает K и V для всех токенов. Но K и V старых токенов не меняются: они зависят только от самих токенов и того, что было до них.
Идея кеша
Значит, их можно посчитать один раз и сохранить:
- Первый токен: считаем K₁, V₁ и кладём в кеш.
- Каждый следующий: считаем K и V только для нового токена и дописываем в кеш.
- Внимание: Q нового токена против всех K из кеша, затем взвешенная сумма V.
Работа на шаг из квадратичной по длине становится линейной. В эксперименте статьи на видеокарте T4 генерация ускорилась с 61 до 11,7 секунды, то есть примерно в 5,2 раза. В библиотеке Transformers кеш включён по умолчанию (use_cache=True).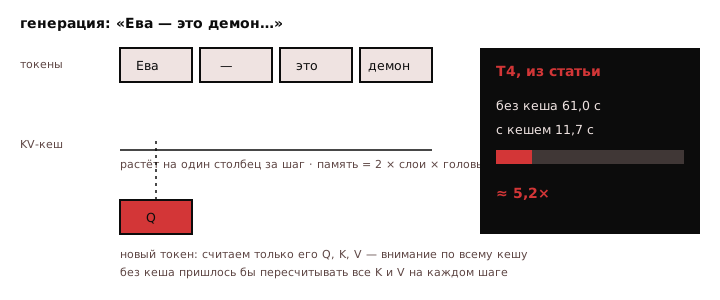
Цена: память
Бесплатно ничего не бывает. Кеш растёт с каждым токеном. Его размер примерно такой:
2 (K и V) × слои × головы_KV × размер_головы × длина_контекста × байт_на_числоДля модели 8B с 32 слоями и контекстом в 32 тысячи токенов в fp16 это несколько гигабайт, сопоставимо с самими квантованными весами. Поэтому современные модели используют Grouped-Query Attention: меньше голов K/V, и кеш меньше в разы.
Мой комментарий
В Еве это напрямую влияет на планировщик. Когда он решает, влезет ли модель в VRAM, он считает не только размер весов, но и бюджет KV-кеша под ожидаемую длину контекста. Поэтому «Узел Зеро» на Gemma-1B после классификации запроса сразу сбрасывает свой кеш: его задача — один короткий JSON, и держать в памяти историю ему незачем. А глубокие модели получают кеш с запасом.
Квантование весов и KV-кеш — две половины одной задачи «уложиться в 8 ГБ».