HNSW: как найти ближайший вектор среди миллиона за миллисекунду
Вчера был RAG, сегодня его двигатель. Чтобы найти куски текста, похожие по смыслу на запрос, нужно найти ближайшие векторы. Перебирать миллион векторов на каждый запрос — дорого. Самый популярный способ делать это быстро — HNSW. В движке контекста Евы используется именно он (hnsw_rs). Разбираю статью Pinecone.
Кирпич 1: список с пропусками
Skip list (Пью, 1990) — это несколько уровней связного списка. Нижний уровень содержит все элементы, каждый следующий — случайную часть элементов предыдущего. Поиск начинается сверху, где длинные прыжки, и спускается вниз, где прыжки короткие. Как ехать сначала по трассе, потом по городу, потом по двору.
Кирпич 2: граф «малого мира»
NSW (navigable small world) — это граф, где каждый вектор связан с несколькими близкими соседями. Поиск жадный: стоишь в вершине, смотришь на соседей, переходишь к тому, кто ближе к запросу. Останавливаешься, когда ближе никого нет.
Проблема в том, что жадный поиск может застрять в локальном минимуме, далеко от настоящего ответа.
HNSW = оба кирпича вместе
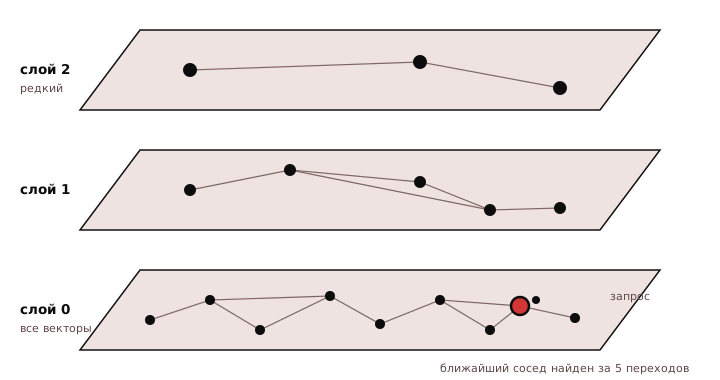
Строим несколько слоёв графа:
- верхние слои разреженные, с длинными связями — быстрое грубое приближение;
- нижние слои плотные, с короткими связями — точное уточнение;
- поиск начинается сверху и на каждом слое спускается туда, где остановился.
Три параметра
- M — сколько соседей у каждой вершины. Больше соседей — выше точность, но прямо пропорционально растёт память.
- efConstruction — сколько кандидатов рассматривается при построении. Улучшает качество графа, на скорость поиска почти не влияет.
- efSearch — сколько кандидатов рассматривается при поиске. Это основная ручка «точность против скорости».
Цифры
На датасете Sift1M (миллион векторов) авторы получили разброс от «80% полноты за 1 мс» до «100% за 50 мс», в зависимости от параметров. Память при этом меняется ещё сильнее: около 0,5 ГБ при M=2 и почти 5 ГБ при M=512.
Если памяти мало, можно сжимать векторы (product quantization) или комбинировать HNSW с инвертированным индексом (IVF). Это меньше памяти, но и меньше точности.
Мой комментарий
У Евы весь бюджет памяти уходит на модели, так что индекс должен быть скромным. В движке контекста стоит M = 16 и ef_construction = 200: индекс строится редко, поэтому на качестве графа экономить незачем. Индексирует он мануалы инструментов, и здесь полнота важнее скорости: пропущенный мануал означает, что модель начнёт выдумывать инструмент. Значит, efSearch стоит держать повыше.
Удивительно, сколько современных ИИ-систем стоит на идее из 1990 года про связные списки.