False sharing: тихий убийца многопоточной производительности
Позавчерашний баг в Еве заслуживает отдельного разбора. Беру классическую статью Мартина Томпсона из блога «Mechanical Sympathy», откуда, по сути, пошло массовое понимание этой проблемы.
Что происходит
Процессор читает память не байтами, а кеш-линиями, чаще всего по 64 байта. Если в одну линию попали две независимые переменные, для кеша это одна сущность.
Теперь два потока на разных ядрах:
- поток A постоянно пишет переменную
x; - поток B постоянно пишет переменную
y; xиyлежат в одной кеш-линии.
Чтобы записать, ядро должно получить линию в эксклюзивное владение (протокол когерентности MESI и его родственники). A забирает линию, и копия у B инвалидируется. B забирает линию, и копия у A инвалидируется. Линия гоняется туда-сюда через общий кеш L3 на каждой записи, хотя логически потоки вообще не делят данные.
Отсюда название: ложное разделение. Данные не общие, но кешу всё равно.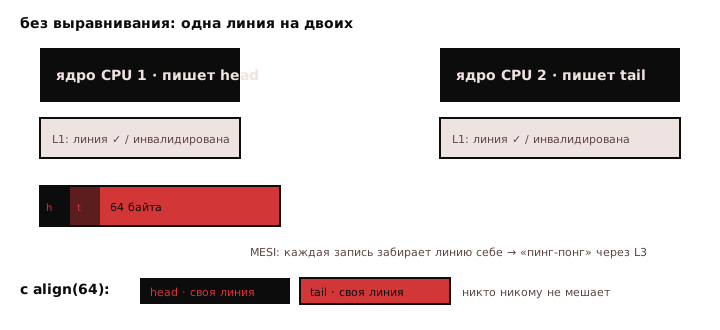
Почему это коварно
По коду ничего не видно. Переменные разные, блокировок нет, гонок нет, тесты зелёные. Просто программа на 4 потоках работает почти так же, как на одном, а иногда и медленнее. Томпсон называет конкуренцию за запись в кеш-линии главным ограничителем масштабирования параллельных потоков.
Эксперимент
В статье несколько потоков в цикле увеличивают каждый свой счётчик в массиве. В первом варианте счётчики лежат вплотную. Во втором каждый дополнен неиспользуемыми полями до размера кеш-линии. Код логически идентичен, но вариант с дополнением масштабируется с ростом числа потоков, а вариант без него упирается в стену.
Как лечить
Выравнивание и дополнение. Каждая «горячая» переменная, которую пишет свой поток, должна занимать свою кеш-линию.
В Rust это одна строчка:
#[repr(C, align(64))]
struct Padded<T>(T);

#[repr(C)]
pub struct OutputRingBuffer {
    pub head: Padded<AtomicUsize>, // своя кеш-линия
    pub tail: Padded<AtomicUsize>, // своя кеш-линия
    pub buffer: [u8; RING_BUFFER_CAPACITY],
}
В стандартной библиотеке нет готового типа, но в crossbeam есть CachePadded, который учитывает, что на некоторых архитектурах полезно выравнивание и до 128 байт: соседние линии там подтягиваются парами.
Мой комментарий
Если этот пост и научил меня чему-то, то вот чему: размер структуры — это часть её API. В Еве тесты уже проверяют size_of::<StateHeader>() == 64. Для кольца теперь будет такой же тест, проверяющий, что head и tail живут в разных линиях. Если кто-то (например, я через полгода) случайно «оптимизирует» раскладку, тест упадёт раньше, чем упадёт производительность.