Eva: оркестратор локальных LLM без единой строчки Python
Сегодня главный пост этого блога. Ради Евы, по сути, всё и затевалось: остальные проекты либо выросли из неё, либо помогают её делать.
Eva — это демон, который управляет несколькими локальными языковыми моделями сразу. Пользователь отправляет задачу, Eva решает, какие модели нужны и в каком порядке, загружает их в видеопамять, гоняет между ними данные и собирает ответ. Всё это на одной видеокарте с 8 ГБ памяти и без единого запроса в интернет.
Зачем, если есть Ollama
Ollama и llama.cpp отлично запускают одну модель. А мне хотелось конвейер: маленькая быстрая модель разбирает запрос, средняя собирает контекст, ещё одна строит план. Как только моделей становится несколько, всплывают три проблемы:
- Связь между ними. Если агенты разговаривают по HTTP и JSON, каждый шаг стоит сериализации, копирования и сетевого стека. Для пайплайна из пяти шагов это заметно.
- Память. Пять моделей в 8 ГБ не помещаются. Кто-то должен решать, кого выгрузить, а кого держать.
- Безопасность. Модель, которой дали инструменты, рано или поздно попробует сделать что-то странное. Сама по себе или потому, что её попросили в промпте.
Eva решает все три.
Как это устроено
Проект собран из четырёх крейтов на Rust:
| Крейт | Что делает |
|---|---|
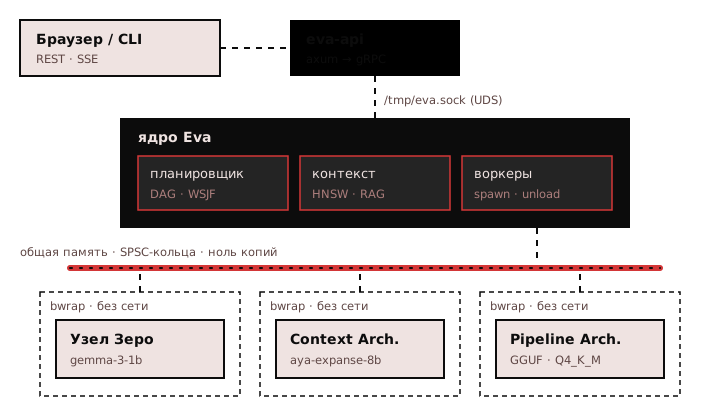
core | Демон: планировщик DAG, движок контекста с RAG, менеджер воркеров |
shared-ipc | Общая память, атомарные заголовки состояния, кольцевые буферы |
worker-candle | Изолированный процесс инференса на HuggingFace Candle |
eva-api | Шлюз: REST и SSE снаружи, gRPC по Unix-сокету внутрь |
Общая память вместо HTTP
Воркеры и ядро обмениваются сырыми байтами через разделяемую память. Внутри лежат кольцевые буферы «один пишет, один читает» (SPSC), которым не нужны блокировки. Структуры описаны с #[repr(C)], поэтому раскладка в памяти фиксирована и одинакова для всех процессов. Подробно об этом слое я писал 10 октября.
Каждый воркер в клетке
Любой процесс с моделью запускается внутри Bubblewrap:
bwrap --ro-bind / / --bind /dev/shm /dev/shm --bind /tmp /tmp --unshare-net -- ./worker-candleФайловая система доступна только на чтение, кроме общей памяти и /tmp, и сети нет совсем. (Про /tmp честный разговор был в посте про пространства имён: там дыра, которую я ещё закрываю.) Если bwrap в системе не найден, Eva не запустится. Это сделано специально: тихо работать без защиты хуже, чем честно упасть.
Планировщик, который умеет вытеснять
Задача превращается в граф шагов (DAG). Порядок выполнения выбирается по формуле WSJF, Weighted Shortest Job First: сначала то, что ценнее всего на единицу затраченного времени. Время каждой модели Eva оценивает по скользящему среднему (EMA) прошлых запусков.
Когда модели не хватает видеопамяти, ядро отправляет кому-то из соседей сигнал UnloadWeights. Воркер выгружает веса и освобождает VRAM, но процесс остаётся живым и готовым загрузиться обратно.
Модели
Веса загружаются в формате GGUF с квантованием Q4_K_M, архитектура определяется по метаданным файла. Для каждой роли своя модель:
- Узел Зеро (
gemma-3-1b): за ~50 мс решает, пойдёт запрос по быстрому шаблону или по глубокому пути. - Context Architect (
aya-expanse-8b): собирает контекст и хорошо дружит с русским языком. - Pipeline Architect строит из собранного план выполнения.
В последних коммитах появились бенчмарк моделей на CPU, GPU и в гибридном режиме, замер задержки при подмене весов, перевод NLLB-200 в Safetensors и сквозные gRPC-тесты.
Стеклянная панель
У Евы есть веб-интерфейс на Svelte, о нём был отдельный пост. Он полностью отделён от ядра: можно закрыть вкладку, удалить фронтенд, а демон продолжит работать, не потеряв ни байта контекста.
Что дальше
- Довести Deep Track до автономного цикла «собрать контекст → построить план → выполнить → проверить».
- Подключить Persona, чтобы у Евы появилось настроение, влияющее на тон ответов (но не на факты).
- Подключить llm-wiki как источник правил по MCP.
Чем меньше у тебя железа, тем честнее приходится думать об архитектуре. 8 ГБ VRAM научили меня большему, чем любой курс.