Eva изнутри: общая память, кольцевой буфер и байт за байтом
Обещанный разбор самого низкого уровня Евы: как ядро и воркеры с моделями обмениваются данными. Здесь нет HTTP, JSON и даже сокетов. Есть кусок общей памяти и договорённость, где в нём что лежит.
Почему не сокеты
Каждый токен, который генерирует модель, должен попасть в ядро. Через сокет это системный вызов, копирование в ядро ОС и обратно, сериализация. Через общую память воркер просто пишет байты по адресу, а ядро их читает. Ноль копий через ядро ОС.
Раскладка памяти
Сегмент общей памяти у каждого воркера устроен одинаково, все смещения зафиксированы константами:
0x000000  StateHeader      64 байта   статус и пульс воркера
0x000040  ControlBlock      1 КБ      модель, длина контекста, лимит токенов, LoRA
0x000440  Input buffer      1 МБ      промпт от ядра
0x100440  OutputRingBuffer  1 МБ+16   поток токенов от воркера
Все структуры объявлены с #[repr(C)], поэтому компилятор не переставляет поля, и раскладка одинакова в любом процессе. Тесты проверяют это буквально:
assert_eq!(size_of::<StateHeader>(), 64);
assert_eq!(size_of::<ControlBlock>(), 1024);
assert_eq!(OUTPUT_RING_BUFFER_OFFSET - INPUT_BUFFER_OFFSET, MAX_INPUT_BUFFER_SIZE);
Последняя проверка гарантирует, что входной буфер не может перелезть на выходной.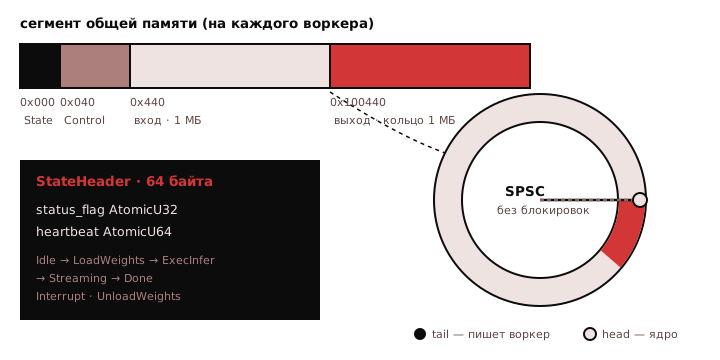
Статусы
В StateHeader лежит атомарный флаг статуса. Ядро и воркер общаются, меняя его:
#[repr(u32)]
pub enum WorkerStatus {
    Idle = 0x0, LoadWeights = 0x1, ExecInfer = 0x2, Streaming = 0x3,
    ReqData = 0x4, Done = 0x5, Error = 0x6, Interrupt = 0x7, UnloadWeights = 0x8,
}
Interrupt — это вытеснение: планировщик решил, что есть задача важнее. UnloadWeights освобождает видеопамять, не убивая процесс. Рядом лежит атомарный worker_heartbeat: воркер обновляет его постоянно, и сторожевой таймер ядра по нему понимает, что процесс жив, а не завис.
Кольцевой буфер
Токены идут через SPSC-кольцо: один производитель (воркер) и один потребитель (ядро). Воркер двигает только tail, ядро двигает только head. Пока у каждого индекса один писатель, блокировки не нужны: достаточно атомарных операций с правильным порядком памяти (запись данных, потом Release-публикация индекса; чтение индекса с Acquire, потом данные).
Баг, который я нашёл, пока писал этот пост
Вот как выглядит структура кольца:
#[repr(C)]
pub struct OutputRingBuffer {
    pub head: AtomicUsize, // пишет только ядро
    pub tail: AtomicUsize, // пишет только воркер
    pub buffer: [u8; RING_BUFFER_CAPACITY],
}
head и tail лежат рядом, в одной кеш-линии на 64 байта. Ядро пишет head на одном ядре процессора, воркер пишет tail на другом, и кеш-линия бегает между ними туда-обратно на каждой операции. Это классический false sharing. Для StateHeader я когда-то специально выровнял всё под 64 байта, а для кольца забыл.
Исправление простое: развести индексы по разным кеш-линиям (#[repr(C, align(64))] для обёрток над индексами). Ещё лучше — заставить каждую сторону держать локальную копию чужого индекса, как в статье Эрика Ригторпа. Её разбор в соседнем посте, а завтра будет подробно про false sharing.
Что я понял
Писать блог полезно: пока объясняешь свой код постороннему, начинаешь видеть его чужими глазами.